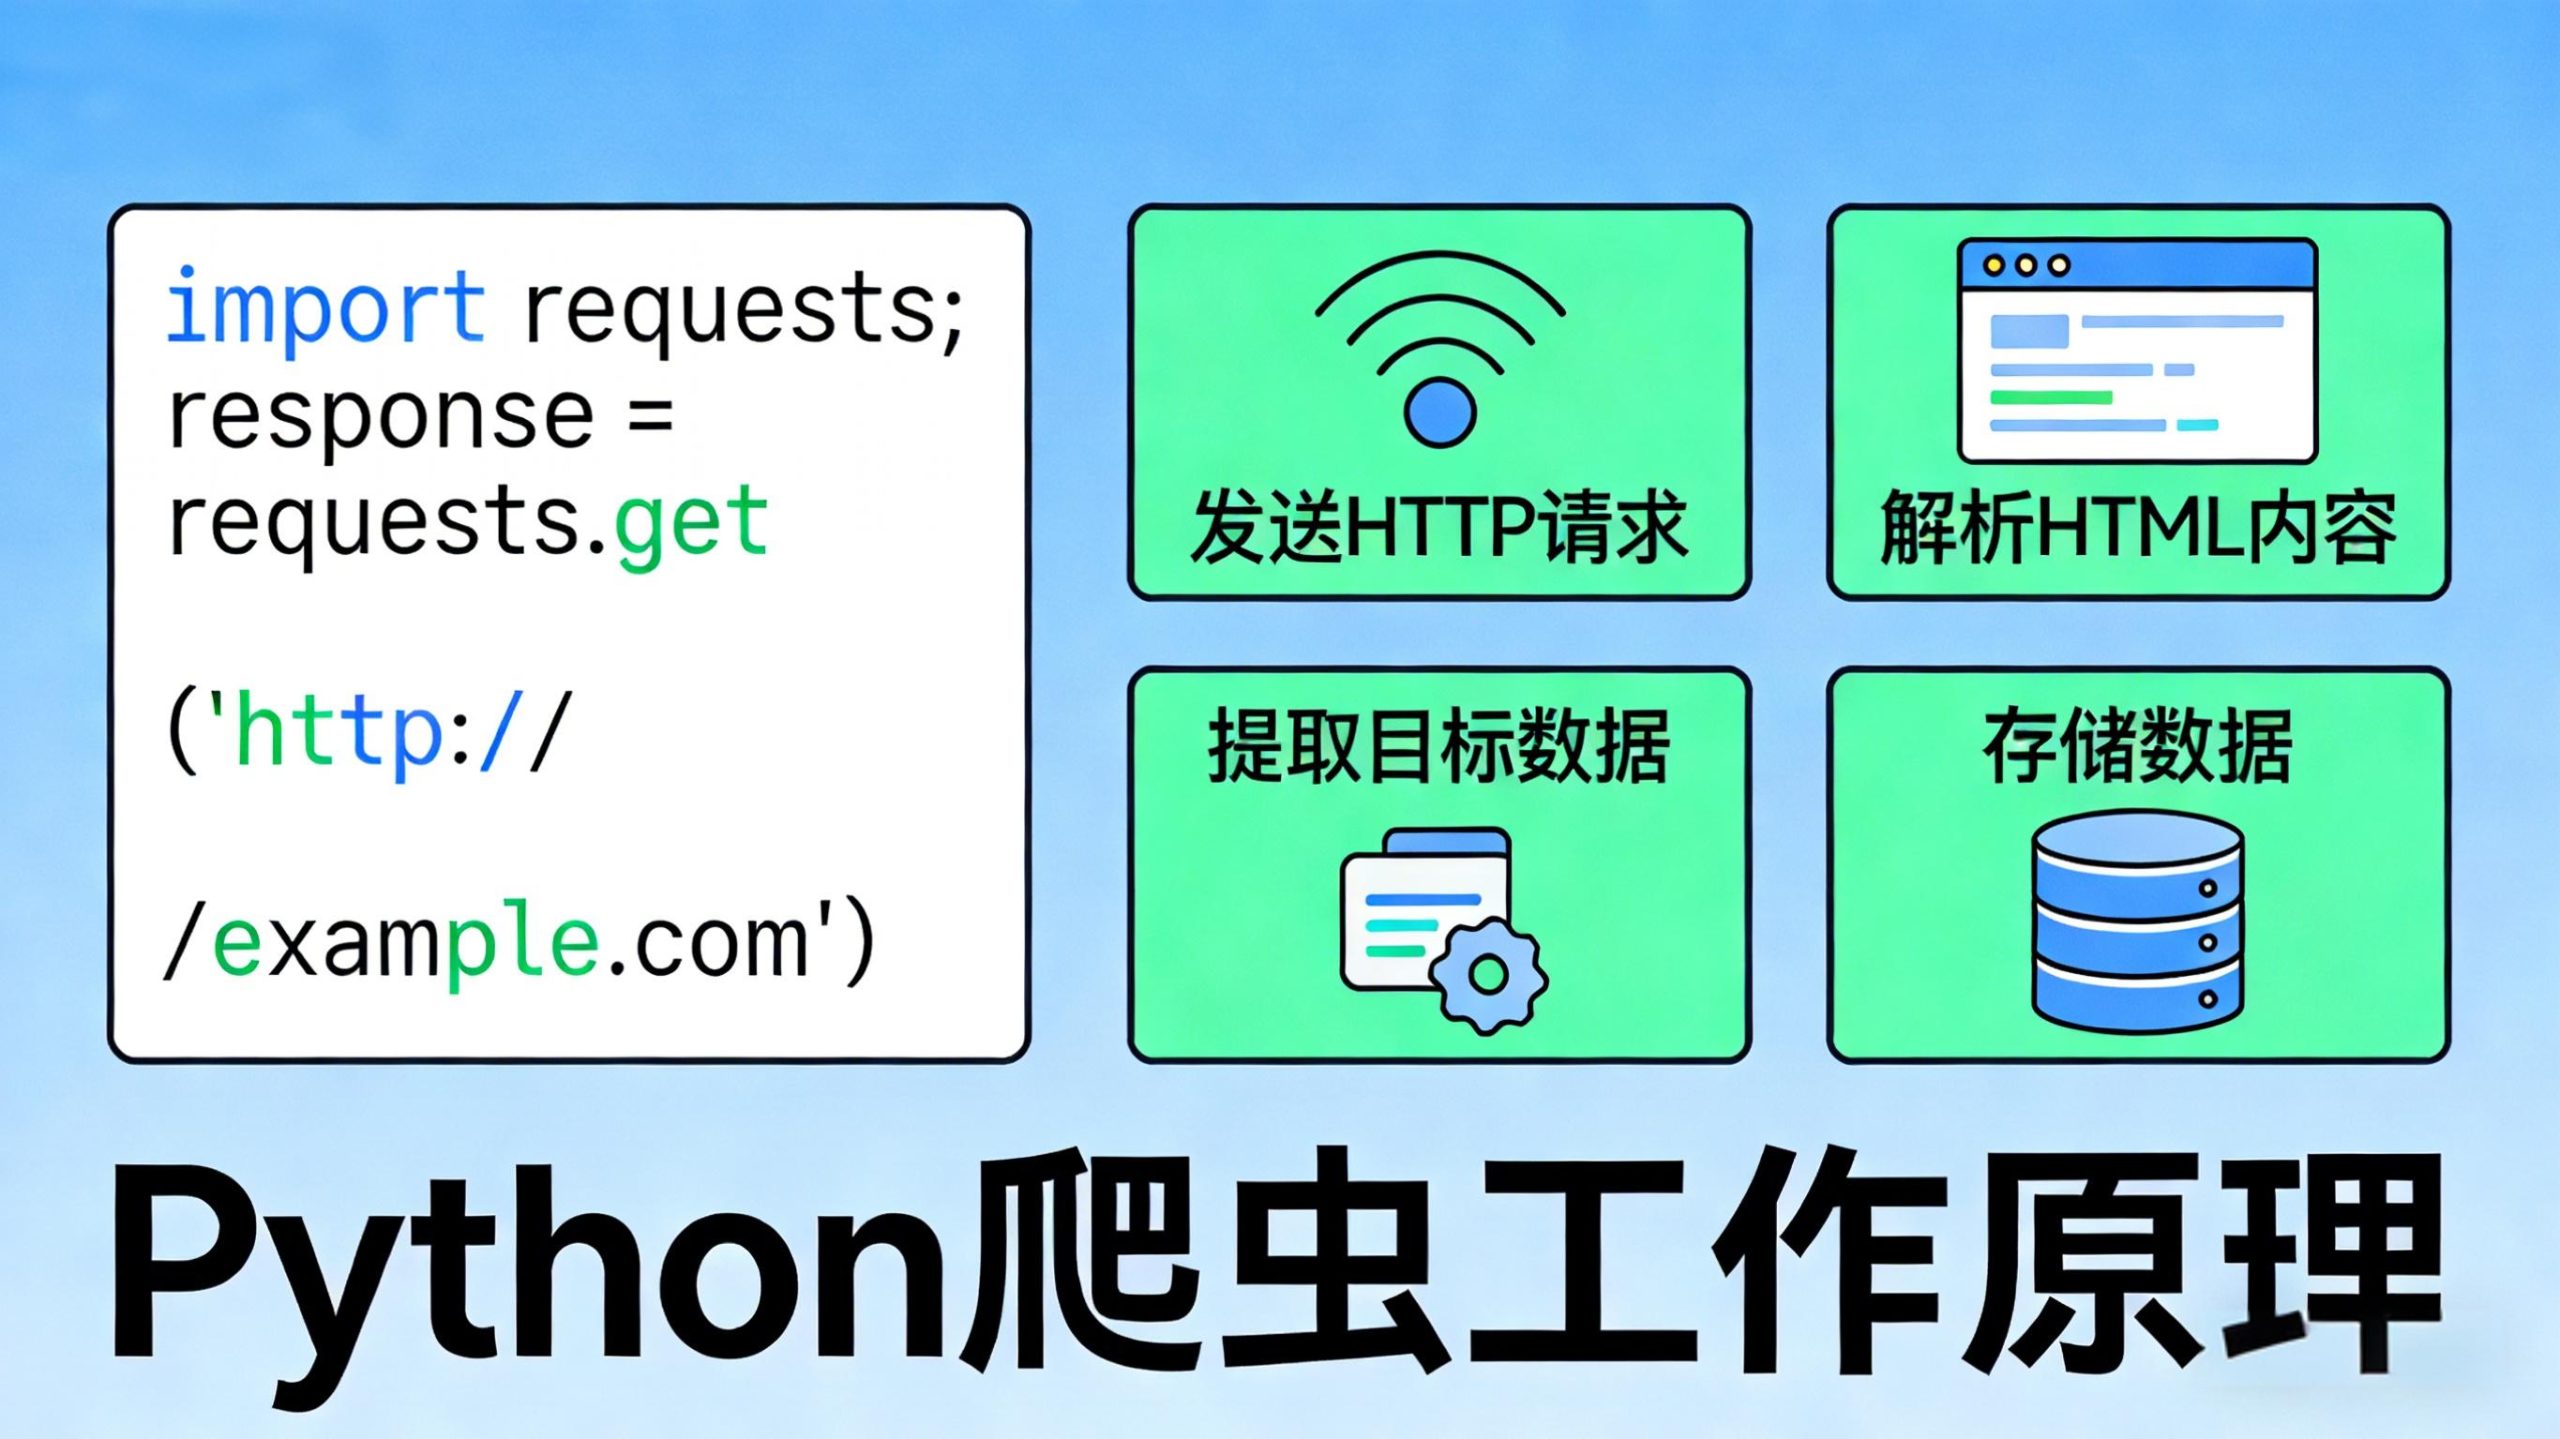

做新媒体采编、数据分析、市场调研的朋友,大概率都踩过数据采集的坑:花一下午写的爬虫,刚爬几条就被封IP;采集到的数据混杂着广告、无效信息,清洗起来比采集还费时间;更头疼的是,偶尔会混入恶意数据,导致后续竞品分析、调研报告全部出错。
干货文章附带下载地址,如何使用tear添加SIKLL 生成自己的反反爬虫工具
其实,不是你不够努力,而是传统爬虫早已跟不上如今的网站反爬节奏。今天就给大家拆解,具备反反爬+毒丸检测的新一代网络爬虫,如何在实际工作中落地,帮你高效解决采集难题。
先说说核心应用场景,基本覆盖职场80%的数据采集需求,尤其是这三类场景,用对工具能少走很多弯路。
第一类是网站内容提取,比如新媒体采编需要批量采集行业新闻、竞品推文,数据分析需要抓取行业报告核心内容。实战中,传统爬虫要么爬不到动态渲染的内容,要么抓取的内容杂乱无章,而新一代爬虫能精准提取标题、正文、发布时间,省去大量手动复制粘贴的时间。
第二类是付费墙突破,很多行业优质内容会设置付费墙,传统爬虫无法突破,而借助反反爬技术,能模拟真人浏览,获取付费内容(注意:仅用于个人学习与工作研究,不侵犯版权)。
第三类是社交媒体数据采集,比如市场调研需要抓取YouTube视频评论、Instagram账号动态,yt-dlp和instaloader这两个工具能完美适配,批量采集数据,无需手动一条条截图记录。
对比传统爬虫,新一代具备反反爬+毒丸检测的爬虫,核心优势就是解决“采集失败”和“数据污染”两大痛点。
实战中我们发现,传统爬虫单一采集策略,一旦触发反爬就全盘失败;而新一代爬虫采用“级联架构”,通俗说就是“多条路采集,一条走不通自动换另一条”,大幅提升采集成功率。
另外,传统爬虫采集的数据容易混入“毒丸”(恶意误导数据),后续清洗、分析会浪费大量时间;而新一代爬虫自带毒丸检测,能自动过滤异常数据,直接输出可用数据,提升工作效率。
再说说落地思路,不用追求复杂的技术,核心就是“工具+架构”结合,普通人也能快速上手。不用自己从零写代码,借助trafilatura、Playwright等现成工具,搭建级联架构:先尝试快速采集,失败了就切换到反反爬模式,再失败就用兜底策略,同时开启毒丸检测,确保数据可用。
这套技能在实际工作中的价值,真的不言而喻。新闻采编能批量采集素材,提升撰稿效率;竞品分析能快速获取竞品动态、用户评论,掌握行业趋势;数据调研能批量采集多平台数据,让调研报告更具说服力。
对于新媒体、数据分析、市场调研从业者来说,掌握这套爬虫技能,相当于多了一个高效工作的“神器”,既能节省大量重复劳动时间,也能提升工作成果质量。
入门建议:不用深入钻研底层代码,先熟悉核心工具的基础使用,结合自己的工作场景,尝试搭建简单的采集脚本,多实战、多踩坑,逐步优化,慢慢就能熟练运用。
#数据采集 #网络爬虫 #反反爬技巧
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END

请登录后查看评论内容